செப்டம்பர் 2025 இல்திங்கிங் மெஷின்ஸ் ஆய்வகத்தில் ஹோரேஸ் அவரும் அவரது சகாக்களும் ஒரு எளிய பரிசோதனையை நடத்தினர். அவர்கள் “ரிச்சர்ட் ஃபெய்ன்மேன் பற்றி என்னிடம் சொல்லுங்கள்” என்ற கோரிக்கையை Qwen3-235B க்கு 0 வெப்பநிலையில் 1000 முறை அனுப்பி, ஒவ்வொரு முறையும் 1000 டோக்கன்களைக் கேட்டனர். 0 வெப்பநிலை என்றால், மாடல் எப்பொழுதும் அதன் மிகவும் சாத்தியமான அடையாளத்தைத் தேர்ந்தெடுக்கும், எனவே நீங்கள் 1000 ஒரே மாதிரியான பதில்களை எதிர்பார்க்கிறீர்கள். கிடைத்தது 80 தனித்துவமான முடிவுகள்.
என்ன கண்ணில் பட்டது எங்கே பதில்கள் பிரிக்கப்பட்டன. முதல் 102 எழுத்துகளுக்கு அனைத்து 1000 நிறைவுகளும் ஒரே மாதிரியாக இருந்தன. 103 மதிப்பெண்ணில், அவர்களில் 992 பேர் “குயின்ஸ், நியூயார்க்” மற்றும் 8 பேர் “நியூயார்க் சிட்டி” உடன் தொடர்ந்தனர். ஆயிரத்தில் எட்டு ரன்கள் ஒரே மார்க்காக மாறியது, 102 மதிப்பெண்களுக்குப் பிறகு, எதுவுமே செய்யவில்லை.
அவர்களின் செய்தி விளக்குகிறது ஏன் வெளியீடுகள் முற்றிலும் வேறுபட்டவை. இந்தக் கட்டுரை மற்றொரு கேள்வியைக் கேட்கிறது: டோக்கன் புரட்ட எவ்வளவு நேரம் ஆகும் மற்றும் ஆபத்து ஏன் அதிகமாக உள்ளது? நான் ஒரு வரி சூத்திரத்தைப் பெறுகிறேன், அதை உருவகப்படுத்துதல் மூலம் சரிபார்த்து, உண்மையான மாதிரியில் சோதனை செய்கிறேன். மடிக்கணினியில் எல்லாம் வேலை செய்கிறது மற்றும் குறியீடு கட்டுரையில் உள்ளது.
ஒலி எங்கிருந்து வருகிறது?
வெப்பநிலை 0 இல், மாடல் அதிக லாஜிட் (அதன் மூல மதிப்பெண்) கொண்ட டோக்கனைத் தேர்ந்தெடுக்கிறது. இது தீர்மானிக்கும் கணிதம், ஆனால் உங்கள் கணினியானது மிதக்கும் புள்ளியில் லாஜிட்களை கணக்கிடுகிறது, அங்கு கூட்டல் துணை இல்லை:
அளவில், அது மோசமாகிறது. நான் 100,000 random float32 எண்களை மூன்று வழிகளில் தொகுத்துள்ளேன். முன்னோக்கி வரிசை −90.82497 ஐக் கொடுத்தது, தலைகீழ் வரிசை −90.82674 ஐக் கொடுத்தது, மற்றும் NumPy சம தொகை −90.82513 ஐக் கொடுத்தது (float64 தரவு −90.82508) ஒரே எண்கள், மூன்று பதில்கள்.
ஒரு நரம்பியல் நெட்வொர்க் பில்லியன் டாலர்கள் செலவாகும், எனவே வன்பொருள் பயன்படுத்தப்படும் விதம் முக்கியமானது. சீரற்ற வரிசையில் முடிவடையும் GPU த்ரெட்களை ஒரு பொதுவான விளக்கம் குற்றம் சாட்டுகிறது. அவள் மற்றும் மற்றவர்கள். இது முக்கிய காரணம் அல்ல என்பதைக் காட்டுங்கள்: ஒரு பொதுவான LLM பாஸ் உண்மையில் அணு சேர்த்தல்களை உள்ளடக்காது, மேலும் அதே கர்னல் ஒவ்வொரு முறையும் ஒரே உள்ளீட்டில் அதே பிட்களை வழங்குகிறது. உண்மையான குற்றவாளி பல கோர்கள் அல்ல கட்சி-மாறாத. அவை குறைக்கப்படும் வரிசையானது தொகுதி அளவுடன் மாறுகிறது, மேலும் பகிரப்பட்ட சர்வரில் தொகுதி அளவு அந்த நேரத்தில் எத்தனை பேர் கோரிக்கைகளை அனுப்புகிறார்கள் என்பதைப் பொறுத்தது. உங்கள் பதில் அந்நியர்களைப் பொறுத்தது.
இது GPU களுக்குக் குறிப்பானது அல்ல என்று ஆசிரியர்கள் சுட்டிக் காட்டுகின்றனர், மேலும் தொகுதி மாறாத கர்னல்கள் அனைத்து 1000 Feynman நிறைவுகளும் ஒரே மாதிரியாக இருந்தன. பிழைத்திருத்தம் ஒரு விலையில் வருகிறது: அவர்களின் சேவை சோதனையில் (ஒற்றை GPU இல் Qwen-3-8B), இயல்புநிலை vLLM க்கு 26 வினாடிகள் மற்றும் ஃபோகஸ் கர்னல் மேம்படுத்தலுக்குப் பிறகு 42 வினாடிகளுடன் ஒப்பிடும்போது உகந்ததாக நிர்ணயிக்கப்பட்ட பதிப்பு 55 வினாடிகளைக் கொண்டிருந்தது.
நெருங்கிய தொடர்புகள் மட்டுமே முக்கியம்
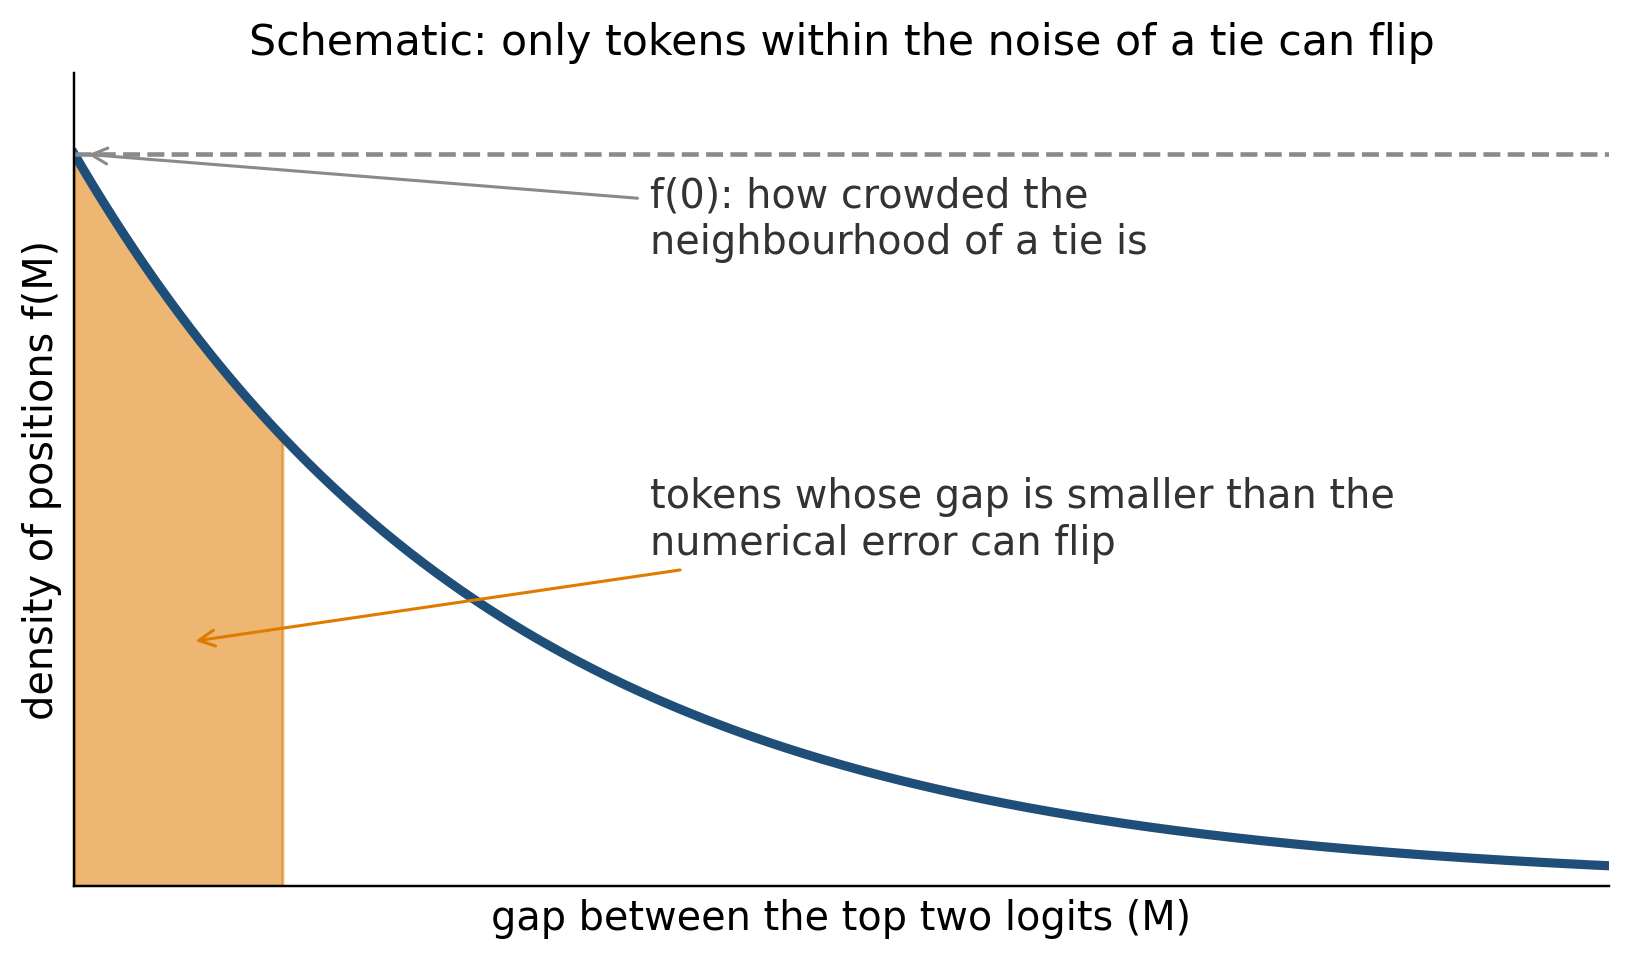
இது ஒரு கணிதவியலாளனாக எனக்கு விருப்பமான பகுதி. z₁ மற்றும் z₂ இரண்டு பெரிய லாஜிட்களாக இருக்கட்டும் மற்றும் அவற்றின் வித்தியாசத்தை அழைக்கவும் விண்வெளி, . எண் சத்தம் இந்த இடைவெளியை ஒரு சிறிய பிழையுடன் மாற்றுகிறது Δ, மற்றும் argmax மாறினால் மட்டுமே .
8 லாஜிட் இடைவெளி கொண்ட டோக்கன் கர்னல் சத்தம் இருந்தாலும் சுழலவே முடியாது. நெருங்கிய இணைப்புகள் மட்டுமே ஆபத்தில் உள்ளன. எல்லா நிலைகளிலும் சராசரியாக, இடைவெளி அடர்த்தியுடன், சுழற்சி நிகழ்தகவு
p = ∫ P(Δ < −m) f(m) dm
சத்தம் சிறியதாக இருந்தால், f கிட்டத்தட்ட நிலையானது, f (0), குறுகிய வரம்பில் இருக்கும் முக்கியமில்லை. ஒருங்கிணைந்த பட்டை எதிர்மறையானது எதிர்பார்த்த பிழையாகும் சமச்சீர் ஒலிக்காக. எனவே
ப ≈ f(0) · E|Δ| / 2
ஒவ்வொரு அடையாளம் உருளும் நிகழ்தகவு, டை அக்கம் பக்கத்தில் எவ்வளவு நெரிசல் உள்ளது மற்றும் எவ்வளவு சத்தமாக உள்ளது என்பதைப் பொறுத்தது. முதல் காரணி மாதிரி மற்றும் உரையுடன் தொடர்புடையது. இரண்டாவது உங்கள் வன்பொருள், துல்லியம் மற்றும் கோர்களுடன் தொடர்புடையது. இது ஒரு எளிய சிறிய வம்பு வாதம், எனவே நான் புதுமையானதாகக் கூறவில்லை. தொடர்புடைய முறைப்படுத்தல், மெசினா மற்றும் ஸ்காட்டாவின் “பின்னணி வெப்பநிலை” (TMLR, 2026), இது போன்ற இடையூறுகளை பயனுள்ள வெப்பநிலையாகக் கருதுகிறது.
சூத்திரம் பின்பற்றப்படுகிறதா?
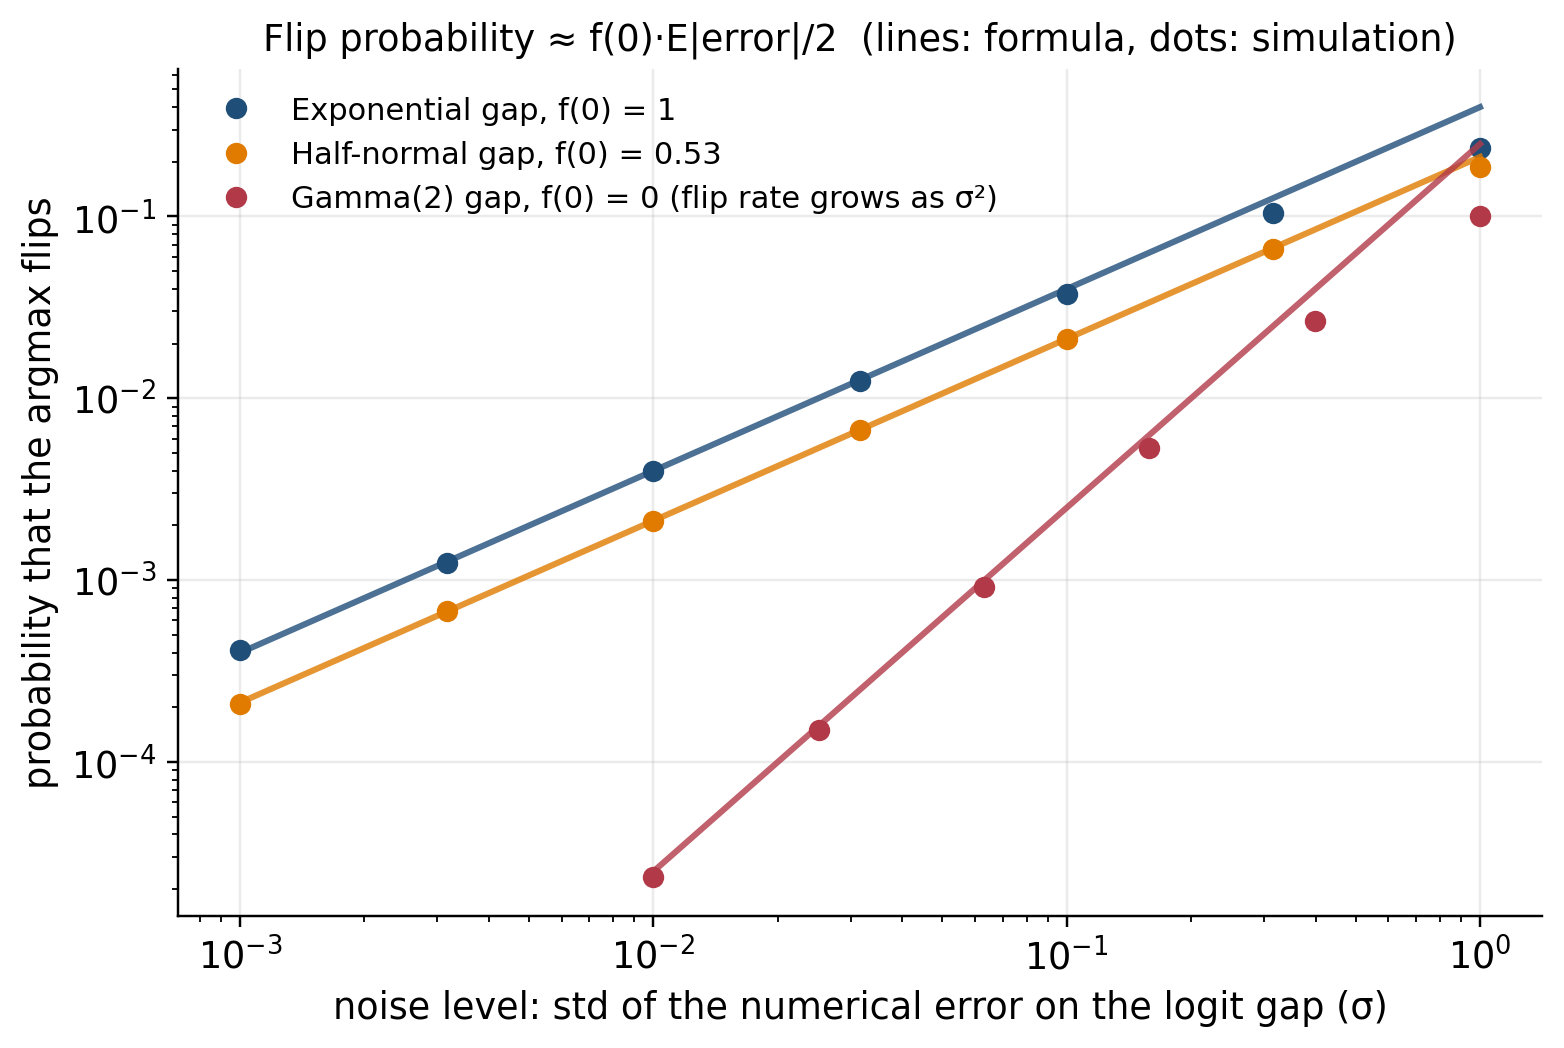
உண்மையான மாடலைத் தொடும் முன், தெரிந்த அடர்த்தி மற்றும் காஸியன் சத்தம் கொண்ட உருவகப்படுத்தப்பட்ட குழியில் சூத்திரத்தைச் சரிபார்த்தேன். . மையமானது ஒன்பது வரிகளைக் கொண்டுள்ளது:
அதிவேக மற்றும் அரை-வழக்கமான இடைவெளிக்கு, உருவகப்படுத்துதல் 4% க்குள் σ க்கு 0.03 வரை சூத்திரத்தைப் பொருத்துகிறது, மேலும் அரை-ஒழுங்குநிலை σ = 0.3 இல் கூட 2% க்குள் இருக்கும் (படம் 2). இரைச்சல் ஒரு பொதுவான இடைவெளியைப் போல பெரியதாக இருக்கும்போது, அது உடைந்து விடும்: σ = 1 இல் அதிவேக கேஸ் எதிர்பார்க்கப்படும் 40% க்கு எதிராக 24% நேரத்தை வழங்குகிறது, ஏனெனில் அடர்த்தியானது முக்கியமான பகுதியில் தட்டையாக இருக்காது.
மூன்றாவது வழக்கு சூத்திரத்தின் அடிப்படை அனுமானத்தைக் காட்டுகிறது, . விண்வெளியின் அடர்த்தி பூஜ்ஜியத்தில் மறைந்துவிட்டால், சுழற்சியின் வேகம் அதிகரிக்கும் அதற்கு பதிலாக (அது பொருந்துகிறது 8% க்குள் σ 0.06 வரை) மற்றும் சத்தம் மிகவும் குறைவான முக்கியத்துவம் வாய்ந்தது. உண்மையான மாதிரி எந்த முறையில் வாழ்கிறது?
உண்மையான மாதிரி
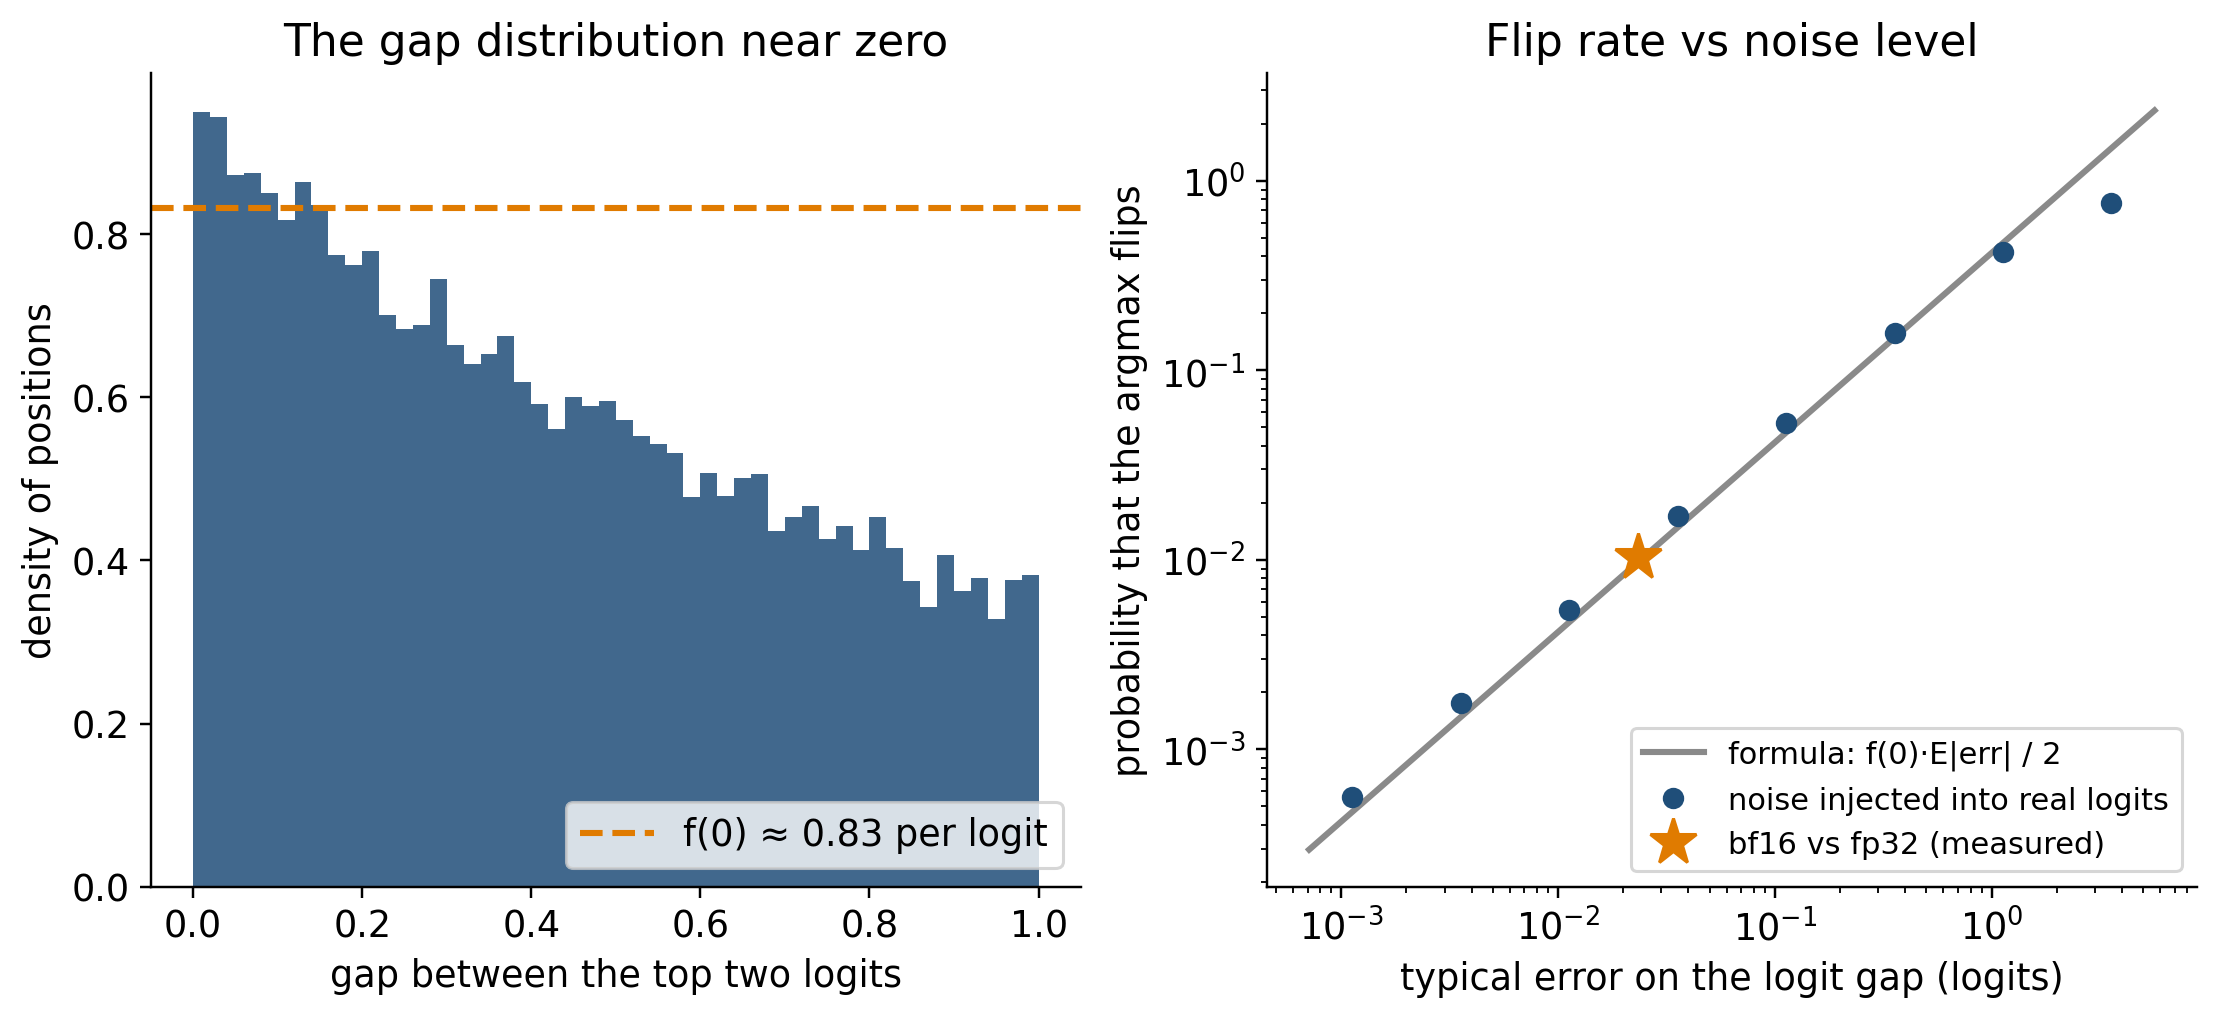
WikiText-2 இலிருந்து 128 டோக்கன்களின் 256 சாளரங்களில் GPT-2 ஐ இயக்கினேன். a உடன் முன்னோக்கி மாற்றம் ஒன்று இது உண்மையான சேவை இரைச்சலின் ஒரு அலகு: ஏற்றப்பட்ட GPU சேவையகத்தின் தொகுதி அளவு விளைவை எனது மடிக்கணினியால் மீண்டும் உருவாக்க முடியாது, ஆனால் இது குறைவான துல்லியமான கர்னல் உருவாக்கும் லாஜிட் பிழையை அளவிட முடியும். மின்மாற்றி பெட்டியை உள்ளே வைத்தேன் மற்றும் வெளியீட்டுத் திட்டம் எனவே, இறுதி பதிவுகள் வட்டமாக இல்லை கரடுமுரடான கண்ணி.
நான் வகிக்கும் ஒவ்வொரு பதவிக்கும் top-20 பதிவுகள், இடைவெளி, அந்த இடைவெளியில் பிழை ரன், மற்றும் argmax புரட்டப்பட்டதா. (வடிவமைப்பு குறியீடு அகற்றப்பட்டது.)
குழியின் அடர்த்தி பூஜ்ஜியமாகும் ஒரு பதிவில், மற்றும் நிலைகளில் 0.1 லாஜிட்டிற்கும் குறைவான இடைவெளி உள்ளது. இல் சராசரிக்கு நெருக்கமான இடைவெளியில் பிழை லாஜிட்ஸ், எனவே சூத்திரம் ஃபிளிப் வீதத்தைக் கணிக்கின்றது . நான் அளந்தேன் . படம் 3 (வலது) உண்மையான லாஜிட்களுக்கு அறியப்பட்ட அளவிலான காசியன் இரைச்சலை அறிமுகப்படுத்துவதன் மூலம் இரைச்சல் மட்டத்தில் ஒப்பிடுவதை மீண்டும் உருவாக்குகிறது.
அறிகுறிகள் முதல் முனைகள் வரை
ஒரு முடிவுக்கு, உயிர்வாழ்வது என்பது ஒவ்வொரு கதாபாத்திரத்தின் உயிர்வாழும் நிகழ்தகவின் விளைபொருளாகும்.
Related Posts

வருகை: “மார்வெரினா கே”க்கு காய்ச்சல் உள்ளது – எலைன் லூயிஸ்
மார்வெரினா சிகிச்சையை நீங்கள் யூகித்தீர்களா? Source link
எல் கிராண்ட் சுஸ்டோ டி அன் கனடோர் டி லா ரூபைக்ஸ்: “எல் காஸ்கோ லே சால்வோ லா விடா”
டிலான் வான் பார்ல் ஒருபோதும் போட்டி இல்லை. எல் கோர்டார் நீர்லாண்டேஸ் டெல் சௌடல் – வேகமான படி sufrió un atropello mientras entrenaba que…

太陽系外の惑星から電波、 முதல் கண்டறிதல் வலுவான காந்தப்புலம் இருப்பதைக் காட்டுகிறது
太陽系外の惑星から電波、முதன்முறையாக, வலுவான காந்தப்புலம் இருப்பது கண்டறியப்பட்டது(1/2)CNN.jp 太陽系外の惑星から電波初正视யாஹூ! செய்தி (CNN.co.jp)யாஹூ! செய்தி Source link